Objekt-Einordnungen von Menschen und KI unterscheiden sich in einem entscheidenden Aspekt
Ähnlich, aber nicht gleich: Auch künstliche Intelligenzen
können inzwischen Bilder, Filme und die Welt um sich herum betrachten
und einordnen. Doch tun sie dies genauso wie wir Menschen? Ein
Experiment zeigt: Die Ergebnisse bei der Objekterkennung sind zwar sehr
ähnlich, die KI kommt aber auf anderem Wege dorthin. Sie ordnet Dinge
eher nach rein visuellen Merkmalen ein, wir Menschen bewerten hingegen
stärker die semantischen Eigenschaften, wie Forscher ermittelt haben.
Künstliche Intelligenzen
übernehmen bereits viele unserer Aufgaben: Sie werten Daten aus,
diagnostizieren Krankheiten, erzeugen Bilder und Filme oder schreiben
Computerprogramme. In manchen Situationen zeigen die KI-Systeme zudem
ein verblüffend menschliches Verhalten: Sie schummeln, lügen, reagieren irrational und könnten sogar schon Kriterien eines freien Willens erfüllen.
Zwei Beispiele für Odd-One-Out-Aufgaben. Zu erkennen ist, welches Objekt am wenigsten zu den anderen passt.
Wie erkennt KI Objekte?
Doch wie nimmt die künstliche Intelligenz Dinge und die Welt um sich
herum wahr? Wie genau erkennt ein KI-Modell Objekte und Zusammenhänge?
Das haben jetzt Florian Mahner vom Max-Planck-Institut für Kognitions-
und Neurowissenschaften in Leipzig und seine Kollegen näher untersucht.
Sie haben verglichen, wie Menschen und neuronale Netzwerke Objekte
erkennen und welche Schlüsseldimensionen sie dabei wahrnehmen und für
ihre Einordnung nutzen.
„Diese Schlüsseldimensionen repräsentieren verschiedene
Eigenschaften von Objekten, die von rein visuellen Aspekten wie ‚rund‘
oder ‚weiß‘ bis hin zu eher semantischen Eigenschaften wie ‚tierbezogen‘
oder ‚feuerbezogen‘ reichen, wobei viele Dimensionen sowohl visuelle
als auch semantische Elemente enthalten“, erklärt Mahner.
Welches Objekt passt nicht zu den anderen?
Für ihr Vergleichs-Experiment nutzte das Team sogenannte
„Odd-One-Out“-Aufgaben: KI und Menschen sehen jeweils drei Objekte und
sollen angeben, welches davon am wenigsten zu den anderen beiden passt.
Um dies zu lösen, müssen die verschiedenen visuellen und semantischen
Merkmale der Objekte erkannt und verglichen werden. Für die Analyse des
menschlichen Verhaltens werteten die Forscher einen Datensatz von rund
4,7 Millionen Entscheidungen über 1.854 verschiedene Objektbilder aus.
Als KI-Pendants verwendeten Mahner und sein Team mehrere
unterschiedliche neuronale Netzwerke, die auf die Aufgabe vortrainiert
worden waren. Dann erhielten sie die gleichen Bilder wie im menschlichen
Test und sollten insgesamt 24.102 Objektbilder in Bezug auf den
Ausreißer bewerten. Mithilfe eines Analyse-Algorithmus ermittelten sie,
welche Merkmale den Entscheidungen der Testpersonen zugrunde lagen.
„Wir behandelten die neuronalen Netzwerke genau wie die
menschlichen Testpersonen beim kognitiven Verhaltensexperiment. Dieser
Ansatz gewährleistet eine direkte Vergleichbarkeit zwischen den beiden“,
erklären die Forscher.
Vergleich der für die Aufgabe von Mensch und KI genutzten Schlüsseldimensionen.
Semantisch versus visuell
„Unsere Ergebnisse zeigen einen wichtigen Unterschied: Während sich
Menschen vor allem auf Dimensionen konzentrieren, die mit der Bedeutung
zusammenhängen – was ein Objekt ist und was wir darüber wissen –,
verlassen sich KI-Modelle stärker auf Dimensionen, die visuelle
Eigenschaften erfassen, wie etwa die Form oder Farbe des Objekts. Wir
nennen dieses Phänomen ,visuelle Bevorzugung‘ in der KI“, berichtet
Mahner.
Eine weitere Auffälligkeit: Selbst in den Schlüsseldimensionen,
in denen Mensch und KI übereinstimmten, fand das Team bei näherer
Analyse auffällige Unterschiede. „Wir stellten fest, dass das Netz diese
Dimensionen nur annähernd erfasste“, berichtet Seniorautor Martin
Hebart vom MPI für Kognitions- und Neurowissenschaften. War
beispielsweise ein Tier in einem Käfig dargestellt, kategorisierten
Menschen dies meist als tierbezogen. Die KI hingegen ordnete das Bild
häufig der semantischen Kategorie Gitter, Käfig oder Draht zu.
Hebart erklärt: „Bei einer tierbezogenen Dimension wurden viele
Bilder von Tieren nicht einbezogen und ebenso wurden viele Bilder
einbezogen, die gar keine Tiere waren. Das ist etwas, das wir mit
Standardtechniken übersehen hätten.“
Unterschiede verdeckt, aber relevant
Nach Ansicht der Forscher demonstriert dies, dass künstliche
Intelligenz oberflächlich betrachtet oft zu gleichen Ergebnissen und
Kategorisierungen kommt wie wir Menschen. Doch um dorthin zu gelangen,
wendet sie oft grundlegend andere Strategien an. „Dieser Unterschied ist
relevant, denn er bedeutet, dass KI-Systeme, obwohl sie sich ähnlich
wie Menschen verhalten, möglicherweise ganz anders denken und
Entscheidungen treffen“, sagt Mahner.
Dies könnte zum einen erklären, warum künstliche Intelligenz
manchmal selbst bei scheinbar leichten Aufgaben spektakulär daneben
liegt. Es zeigt aber auch, dass selbst bei scheinbar gut passenden
Urteilen und Entscheidungen der KI Vorsicht angebracht ist. „Diese
Unterschiede wirken sich auch darauf aus, wie sehr wir den KI-Systemen
vertrauen können“, sagt Mahner.
Die Wissenschaftler plädieren dafür, auch in anderen Bereichen
künstliche Intelligenz und Mensch direkter miteinander zu vergleichen.
Nur so könne man besser verstehen, wie KI die Welt wahrnimmt. „Unsere
Forschung bietet eine klare und interpretierbare Methode, die uns hilft,
besser zu verstehen, wie KI im Vergleich zum Menschen Informationen
verarbeitet“, sagt Hebart. „Dieses Wissen kann uns nicht nur helfen, die
KI-Technologie zu verbessern, sondern liefert auch wertvolle Einblicke
in die menschliche Kognition.“ (Nature Machine Intelligence, 2025; doi: 10.1038/s42256-025-01041-7)
Quelle: Justus-Liebig-Universität Gießen; 24. Juni 2025
- von Nadja Podbregar
Nota. - Menschliches Wissen beruht auf Erfahrung. Erfahrung ist eine Synthese aus Anschauung und Begriff. Anschauen geschieht im Fluss des Handelns.
Die Maschine schaut nicht an und handelt nicht. Die 'Informationen', aus denen sie ihre Urteile zusammensetzt, sind bereits von Wissenden so zureitet, dass die Ma-schine "was damit anfangen kann". Der Maschine kommen ihre Erkenntniss nicht aus Erfahrungen - digitalisierten Analoga -sondern aus bloßem Digitum. Was in die Maschine hineinkommt, ist bereits bezeichnet und wird nicht angeschaut. Sie sieht keine Bilder, sondern verrechnet Pixel.
Unter diesen Umständen ist es bereits irreführend, von Wahrnehmen zu sprechen. Die Maschine registriert und kombiniert nur Zeichen, die sie nicht selber gewählt und angebracht hat, und verwendet sie in Vorgängen, die ihr vorgeschrieben waren, und gleichberechtigt mit Vorgängen, die ihr mal eben so einfallen - denn wie könnte sie sie unterscheiden? Dass sie auch ihr eigenes Verfahren nicht anschauen kann, weiß sie nicht, sie kann nicht einmal ahnen, was das wäre!
Ich vermute sogar, ihr fehlt aus diesem Grund die Fähigkeit der Reflexion - die Fähigkeit, irgendetwas auf "sich selbst" zu beziehen - denn ich selbst werde ich in der Anschauung der Andern, durch die ich erst mich selbst anschaue.*
Doch kann die Maschine sich nicht korrigieren? Das ist ja wohl Reflexion! - Nein, die Maschine korrigiert nicht sich, sondern einen Rechenvorgang, von dem sie nicht einml weiß, dass es ihrer war. Sonst fände sie ihn gar nicht, das ist wahr, aber davon weiß sie nichts. Mit andern Worten - ihr fehlt der Sinn, denn ohne Rückbeziehung auf mich bleibt alles bloße Rechnerei, die nichts bedeutet und die man ebensgut unterlassen kann.
*) Voraus geht ein Fühlen meines Leibes. Die Maschine hat weder dieses noch jenen. JE
In seinem "ästhetischen Zustand" sei der Mensch gleich Null, sagte Schiller. Denn wenn er sich in einen Gegenstand versenkt, hört er auf, sich ihm entgegen zu setzen - oder sonst ein Verhältnis zu ihm einzugehen. Er geht in dem, was er 'ohne Inter-esse' betrachtet, unter, er verliert sich. Das
hat erst was zu sagen in einem Leben, das sich im Normalfall
ununterbrochen selber reflektiert. Kurz gesagt, in einem bürgerlichen,
geschäftigen Leben, in einem Alltag als Marktsubjekt. Ob
es Kunst 'immer gegeben' habe, mag eine Haarspalterei sein. Aber sie
hat nicht immer dieselbe Bedeutung gehabt. Wie sich die Kunst selbst
verändert hat, kommt hier erst an zweiter Stelle. Der Platz des Ästhetischen hat sich verändert.
Welche Verstrickungen mit dem geschäftigen Leben die Kunst auch immer
eingegangen war, blieb sie doch immer an ein ästhetisches, nämlich
geschmackliches Substrat gebunden. Und mit dem Überhandnehmen der
reflektierenden Geschäftigkeit tritt es ihr als das interesselose
Ungeschäftige entgegen. Semantisch wäre es schief, aber bildhaft ganz
treffend ausgedrückt: So ist die Kunst "erst auf ihren Begriff
gekom-men". Es ist aber auch die Epoche, in der Zeit knapp wurde - so grundsätzlich knapp, dass sie zum allgemeinen Wertmaß
werden konnte. Je dringender dem Individuum das Bedürfnis wurde, als
Kontrapunkt zur Alltagskonkurrenz immer wiedermal von Identität und
Verhältnis abzusehen, um so seltener, umso kostbarer wurden die
Gelegenheiten dazu. Und umgekehrt proportional: je knapper die Zeit, umso stär-ker das Bedürfnis. Die es sich am ehesten noch leisten konnten, legten am wenig-sten Wert darauf; erst die ganz
Reichen konnten sich den "ästhetischen Zustand" dann wieder leisten. Er
wurde nun zum Standesmerkmal so, wie es vordem die kunststilistische Bildung gewesen war. Und
damit zum Autor: Mit "der Moderne" wurde der Künstler zum
Avantgardisten - und das erlesene Publikum zum Connoisseur. Anders
hätte es eine ungegenständ-liche Kunst nie geben können. Denn da das Bedürfnis nach kontrapunktischer Irre-flexibilität ein allgemeines wurde,
geschieht seine Bedienung nun ihrerseits
durch - den Markt. Die Kirsche auf dem Sahnehäubchen braucht einen
sättigenden Kuchen als Grundlage; damit es erlesene Kunstgeben kann, muss es zuvor Massenkunst ge-ben. Von
Kitsch rede ich hier nicht, der gilt nicht als Kunst, sondern als
Industrieware. Damit sich oben - gottlob nur vorübergehend - eine
ungegenständliche Kunst kri-stallisieren konnte, musste sich an der Basis
ein Kunstgegenstand finden, der streng genommen kein Gegenstand mehr war, weil er zu den nützlichen Geschäften in kei-nem Verhältnis steht. Das war die Landschaft.
Es konnte nicht anders sein, als dass die Ungegenständlichkeit aus
der Ausbreitung der Landschaftmalerei erwuchs - von den Impressionisten
über Les Fauves bis Mondrian und Klee. Indes hat die Ungegenständlichkeit die Malerei - wenigstens das Tafelbild -
an den Rand des Untergangs geführt. Unter den verzweifelten
Rettungsversuchen nehmen Rückgriffe auf die Landschaft einen breiten
Raum ein. Sie haben nur leider einen organischen Hang zu Manier und Kitsch, dem nur wenige widerstehen. Dass sie das kompromittiert, ist nicht zu übersehen.
PS. - Landschaft ist ohnehin nur ein Bild: Ansicht. Real ist Topographie - auch wenn man die Augen schließt und auch nachts.
Landschaftsmalerei ist Bild von einem Bild. Ihr Gegenstand ist schon eine Abstrak-tion vonderGegenständlichkeitderGegenstände. Früheroderspätermusstesiedar-über stolpern.
Neue Studie mit Orang-Utans So entdeckten Urmenschen die Sprache. Umweltveränderungen vor Millionen Jahren könnten die
Entwicklung der menschlichen Sprache maßgeblich vorangetrieben haben.
Forschende glauben, dass mit den Konsonanten alles anders wurde.
Von Lilly Zerbst, SWR Vor mehr als fünf Millionen Jahren sanken die Temperaturen auf der Erde.
Das Klima wurde trockener, und der Lebensraum veränderte sich. Die
Vorfahren des Menschen waren gezwungen, sich vom Leben in den Bäumen auf
das Überleben im Flachland umzustellen.
Dieser Lebensraumwechsel könnte die von ihnen genutzten Stimmlaute
verändert haben. Zu diesem Schluss kamen Forschende aus England, indem
sie die Rufe von Orang-Utans untersucht haben. Es ist ein Hinweis
darauf, wie der Mensch zu seiner einzigartigen Sprachfähigkeit kam. Ihre
Ergebnisse veröffentlichten die Forschenden nun im Fachmagazin "Scientific Reports".
Sprache macht den Menschen
Unsere komplexe Sprache ist eine Voraussetzung dafür, dass sich der
Mensch so weit entwickeln konnte. Durch sie können wir Gedanken und
Gefühle austauschen, Wissen überliefern und Neues lernen.
Wie der heutige Mensch aber zu einer so hochentwickelten Sprache kam -
dieser Frage widmet sich Primatologe Adriano Lameira von der Universität
Warwick in England. In einem Gespräch mit dem SWR erklärt er:
Sprache ist wirklich einzigartig. Sie ist ein
System, das auf sehr spezifischen Regeln basiert, wie bestimmte
Bausteine miteinander kombiniert werden. Man kann eine endliche Menge
von Bausteinen in eine unendliche Menge von Botschaften verwandeln. Das
ist es, was Sprache so kommunikativ macht, und zwar in einem Ausmaß, wie
wir es von keinem anderen System in der Natur kennen. Adriano Lameira, Primatologe Warwick University, England
Konsonanten sind der "Kleber" unserer Sprache
Damit aus einer Menge wirrer Laute eine komplexe Sprache entstehen kann,
brauchen wir ganz bestimmte Bausteine: Konsonanten. Unsere Sprache
besteht aus zwei Arten von Lauten: Konsonanten und Vokalen. Vokale
werden mit dem offenen Mund gebildet. Dabei entweicht die Luft
ungehindert – so wie bei der Aussprache von A, E, I, O und U.
Konsonanten sind Laute, die durch die Verformung des Mundes und der
Zunge gebildet werden. Dadurch wird die ausströmende Luft behindert und
es entstehen Laute wie K, P, S und T.
Laute einer Gruppe lassen sich zusammengereiht nur schwer aussprechen.
Baut man sie jedoch im Wechsel aneinander, so ergeben sich Silben und
Wörter, die einfacher gesprochen und verstanden werden können. Darum
spielen Konsonanten in allen heutigen Sprachen eine wichtige Rolle.
Warum sich die Konsonanten anders als bei anderen Tieren in unserer
heutigen Sprache fest etabliert haben und so das Entstehen einer
komplexen Sprache ermöglichten, war bisher unklar. Ausschlaggebend soll
aber die Zeit des mittleren bis späten Miozäns gewesen sein. In diesem
geologischen Zeitalter vor 16 bis fünf Millionen Jahren veränderten sich
das Klima und die Landschaft auf der Erde drastisch. Sprachforschende
nennen das Zeitalter eine "ökologische Blackbox": Hinein ging ein wild
rufender Menschenaffe und heraus kam ein sprachfähiger Mensch.
Orang-Utans als "lebendes Modell" der Urmenschen
Lameira und sein Forschungsteam vermuten, dass der extreme
Lebensraumwandel im Miozän eine wesentliche Rolle bei der
Sprachentwicklung unserer Vorfahren gespielt haben könnte. Um dies zu
untersuchen, warfen sie einen Blick auf unsere nächsten Verwandten. "Wir
können Konsonanten nicht rekonstruieren, indem wir unsere DNA
entschlüsseln, also müssen wir wirklich lebende Modelle verwenden.
Deshalb sind Menschenaffen so wichtig", sagt der Primatologe Lameira.
Die Forschenden nutzten Rufaufnahmen von Orang-Utans aus Sumatra und
Borneo, um die Sprachentwicklung der Urmenschen zu studieren. Unter den
Menschenaffen verfügen Orang-Utans über ein besonders großes Repertoire
an konsonantenartigen Lauten. Das ermöglicht ihnen, aus einzelnen Lauten
komplexere silbenartige Rufe zusammenbauen.
Sie besitzen also eine ähnliche Sprachfähigkeit wie unsere Vorfahren vor
Millionen von Jahren, vermuten die Forschenden. Und sie sind die
einzigen Menschenaffen, die in Bäumen wohnen - ein guter Kandidat also,
um den Übergang von Baum zu Boden vor Millionen von Jahren zu
rekonstruieren.
Wie unterscheiden sich Konsonanten von Vokalen?
Wie alle Menschenaffen können Orang-Utans vokalartige und
konsonantenartige Laute bilden. Die untersuchten vokalartigen Laute
ähneln einem tiefen Raunen und entstehen durch die Vibration der
Stimmbänder. Die konsonantenartigen Laute der Orang-Utans ähneln einem
Kuss-Geräusch. Die Menschenaffen erzeugen sie, indem sie ihren Mund
verformen und Luft hindurchpusten.
Forschende rekonstruieren Umsiedlung auf das Flachland
Die Orang-Utan-Laute spielten die Forschenden in der südafrikanischen
Savanne ab. So wollten sie den extremen Übergang simulieren, der
passiert, wenn das Sprachrepertoire eines baumbewohnenden Menschenaffen
in eine offene Landschaft gebracht wird, erklärt Lameira.
Mit einem Mikrofon nahmen die Forschenden die abgespielten
Orang-Utan-Töne dann in verschiedenen Abständen zum Lautsprecher wieder
auf. So wollten sie feststellen, wie gut die insgesamt knapp 500
Aufnahmen der Orang-Utan-Rufe zu hören sind. Konsonantenartige Laute sind besser hörbar
Das Ergebnis: Bei einer Entfernung von 100 Metern waren
konsonantenartigen Rufe deutlich besser registrierbar als vokalartige.
In 400 Metern Entfernung waren die vokalartigen Rufe dann sogar
weitestgehend unhörbar, während die konsonantenartigen Rufe noch zu 80
Prozent wahrnehmbar waren.
Das Verwenden von Konsonanten bot den Urmenschen, die in die Ebene
ziehen mussten, möglicherweise eine höhere Zuverlässigkeit bei der
Übermittlung von Botschaften über weitere Distanzen. Dieser Vorteil
könnte ihre Stimmentwicklung wesentlich beeinflusst haben - hin zu einer
konsonantenhaltigeren Sprache.
Konsonanten erleichtern das Sprachenlernen
Die essenzielle Rolle der Konsonanten lässt sich auch heute noch bei der
Sprachverarbeitung von Kindern beobachten: Je mehr verschiedene
Konsonanten ein Säugling in der Phase des Sprachenlernens hört, desto
früher unternimmt er in der Regel auch selbst Sprechversuche. Dass
Konsonanten besser hörbar - also auffälliger - sind, spielt dabei eine
wesentliche Rolle.
Nota. - Man unterscheidet beim Menschen ein episodisches von einem seman-tisches Gedächtnis. Im episodischen Gedächtnis sind Ereignisse aufbewahrt, die natürlicher Weise in Bildern gemerkt werden. Das semantisch Gedächtnis bezeich-net dagegen, was die Bilder bedeuten: ihren Sinn. Es ist offenbar das höhere Vermögen von beiden und dasjenige, was wir den Tieren voraushaben, und dazu brauchen wir - Sprache.
Gr. sêma heißt Zeichen, und das Semantische am semantischen Gedächtnis sollten daher die Zeichen Sein; jedoch versteht man unter Semantik gerade nicht das tech-nisch-Modale, sondern eben: das Sinnhafte (das seinerseits das Gegenteil vom Sinn-lichen ist). Das ist ein wenig irritierend, aber ohne tiefere Bedeutung, und muss nur als Vokabel gelernt werden.
Immer mehr Alleinerziehende in Deutschland sind Väter In Deutschland wächst der Anteil von Vätern, die als Alleinerziehende mit ihren minderjährigen Kindern leben. 15 Prozent der Alleinerziehenden waren im Jahr 2022 Väter, wie das Statistische Bundesamt mitteilte. Zehn Jahre zuvor hatte ihr Anteil bei zehn Prozent gelegen.
In diesem Zeitraum hat auch die Gesamtzahl der alleinerziehenden Väter mit Kindern zu-genommen: von 166.000 im Jahr 2012 auf 239.000 im Jahr 2022. Das entspricht einer Zu-nahme um 44 Prozentpunkte.
Die Zahl alleinerziehender Mütter ging im selben Zeitraum um zehn Prozentpunkte zurück: von 1,48 auf 1,33 Millionen. Damit sind immer noch deutlich mehr Mütter als Väter allein-erziehend.
Insgesamt wächst in knapp jeder fünften Familie ein Kind unter 18 Jahren mit einem El-ternteil auf. Rund 1,57 Millionen Alleinerziehenden-Familien lebten 2022 in Deutschland. Im Vergleich zu 2012 ging ihre Zahl leicht zurück. Damals hatten 1,64 Millionen Allein-erziehenden-Familien in Deutschland gelebt.
Quelle: dpa/AFP/fmp.
Nota. -Da hieß es eben noch, wir lebten in semantisch sensitiven Zeiten: "Sag bloß kein Wort mit N!" Wenn aber kein Gender und nix Postkoloniales involviert ist, quatschen sie gedankenverloren aus sich raus.
Hätte vor fünfzig Jahren ein Elternpaar bekundet "Wir erziehen unsere Kinder allein", dann hätten in manchem Jugendamt die Signalklingeln geschrillt, und nicht nur in den sozialde-mokratisch gesonnenen: "Das demokratische Gemeinwesen erzieht gottlob überall mit!" Oder prosaischer gesagt, unsere freiheitliche Zivilgesellschaft; Lehrer und Erzieher, Ver-kehrspolizisten und Bademeister, Eisverkäufer und... nun ja, ein paar weniger gerngesehene Dealer auch, aber das ist der Preis der Freiheit, die an ihren Herausforderungen wächst.
Und dann wurde aus einer unsäglichen Anmaßung eine schamlose Impertinenz: Vereine "alleinerziehender Mütter" schossen ins Kraut. Dass grinsend "... und Väter" hinzugefügt wurde, machte das selbstgerechte Dutzend voll: Mein Bauch gehört mir; und sein... gleich mit.
In den Sechzigern war gerade um die Bedürfnisse und wohl gar Rechte von Kindern viel Aufhebens gemacht worden. Und nun wurde deutlich, dass es doch eigentlich immer um die Bedürfnisse der Aufmerksamkeitserreger gegangen war. Die so ewig unterdrückten Be-dürfnisse und Rechte von Frauen! hatten Pandora als Büchsenöffner gedient. Wokeness und Letzte Generation, ich ahne es, sind noch nicht der Schlusspunkt. Identität gilt überall und allein.
JE
Nota.Das obige Foto gehört mir nicht, ich habe es im Internet gefunden. Wenn Sie der Eigentümer sind und seine Verwendung an dieser Stelle nicht wünschen, bitte ich um Nachricht auf diesem Blog.JE
aus scinexx.deSchimpansen stoßen je nach Situation verschiedene Rufe aus – aber können sie diese auch sinnvoll kombinieren? zuJochen Ebmeiers Realien
Schimpansen nutzen auch kombinierte Rufe Menschenaffen demonstrieren erste Ansätze einer kompositionellen Syntax
Neu kombiniert: Schimpansen könnten schon eine erste Voraussetzung für echte Sprache besitzen, wie Beobachtungen in Uganda nahelegen. Demnach kombinieren die Menschen-affen in bestimmten Situationen zwei Laute mit verschiedener Bedeutung miteinander – und geben ihnen damit eine neue Bedeutung. Diese Fähigkeit zur sinnvollen Kombination, kompositionelle Syntax genannt, könnte demnach schon bei den gemeinsamen Vorfahren von Menschenaffe und Mensch entstanden sein.
Ob mit „Huh“-Rufen, Grunzlauten oder Schreien: Auch Menschenaffen nutzen verschie-denste Lautäußerungen, um zu kommunizieren. Sie drücken damit Aggression, Wohlbe-hagen oder Angst aus und nutzen auch spezielle Alarmlaute, um ihre Artgenossen zu warnen. Ob Gorilla, Schimpanse und Co diese Laute jedoch kontrolliert verändern und kombinieren können oder ob sie rein instinktgesteuert sind, ist strittig – und damit auch, ob Menschenaffen schon das Rüstzeug für eine echte Sprache besitzen.
Ist Fähigkeit zur Bedeutungskombination einzigartig menschlich?
Doch wie sich nun zeigt, beherrschen Schimpansen offenbar doch ein erstes Merkmal echter Sprache: die Fähigkeit, einzelne Laute zu neuen Einheiten zusammenzufügen. Wir nutzen diese kompositionelle Syntax beispielsweise, um einzelne Wörter zu sinnvollen Sätzen zusammenzufügen oder um Dinge näher zu beschreiben – aus „Ball“ wird der „rote Ball“. Wann unsere Vorfahren diese Fähigkeit zur Kompositionalität jedoch entwickelten, ist bisher unklar.
„Der evolutionäre Ursprung dieser Fähigkeit ist umstritten, dabei geht es vor allem um die Frage, ob die kompositionelle Syntax ein einzigartiges Merkmal nur der menschlichen Kommunikation ist“, erklären Maël Leroux von der Universität Zürich und seine Kollegen. Zwar können einige Affenarten unter bestimmten Bedingungen zwei verschiedene Rufe kombinieren. Weil diese aber nicht zu den Menschenaffen gehören, ist strittig, ob dies nicht eine konvergente Entwicklung und damit keine evolutionäre Errungenschaft unserer direkten Affenvorfahren ist. Das Experiment mit der Schlange
Um dieser Frage nachzugehen, haben Leroux und sein Team wilde Schimpansen in Uganda auf die Probe gestellt. Sie wollten wissen, ob diese Menschenaffen in spezifischen Situationen vielleicht doch eine kompositionelle Syntax nutzen. „Schimpansen produzieren Huu-Rufe, wenn sie überrascht werden, und ein Waa-Gebrüll, wenn sie bei Aggressionen oder bei der Jagd Unterstützung brauchen“, erklärt Leroux. Was aber passiert, wenn die Primaten von einer Bedrohung überrascht werden, bei der sie die Hilfe ihrer Artgenossen benötigen?
Für ihr Experiment versteckten die Biologen eine von einer echten Pythonhaut überzogenen Gummischlange im Gebüsch. Kam ein Schimpanse vorbei, zogen sie an einer Schnur, so dass die Schlange abrupt vor dem Schimpansen auftauchte. Anschließend zeichnete das Team die ausgestoßenen Laute des überraschten Affen auf und beobachtete, wie die Artgenossen auf seine Rufe reagierten. Alarm- und Hilferufe kombiniert
Es zeigte sich: Beim überraschenden Auftauchen der bedrohlichen Schlange stießen die Schimpansen manchmal nur den Alarmruf Huu aus, in neun von 21 Tests kombinierten sie den Huu-Laut aber mit dem Waa-Ruf nach Unterstützung. „Unsere Beobachtungen legen nahe, dass die Tiere mehrere Rufe kombinieren, wenn sie einer Bedrohung ausgesetzt sind und andere Gruppenmitglieder zur Verteidigung rekrutieren wollen. So zum Beispiel bei der Begegnung mit einer Schlange“, sagt Leroux.
Tatsächlich bewirkte die Huu-Waa-Lautkombination bei den Artgenossenen des rufenden Schimpansen eine spezifische Reaktion: Während sie bei bloßen Alarmrufen meist wegblieben, eilten sie bei der Rufkombination deutlich häufiger herbei. Ähnlich fiel die Reaktion aus, als die Forschenden die verschiedenen Rufe per Lautsprecher ertönen ließen: „Das Playback der Huu-Waa-Kombination rief stärkere Reaktionen hervor, sie schauten beispielsweise länger hin und reagierten schneller als bei bloßem Alarm-Huus“, berichtet das Team.
Erbe schon unserer gemeinsamen Vorfahren?
Nach Ansicht von Leroux und seinem Team deuten diese Beobachtungen darauf hin, dass Schimpansen zumindest erste Ansätze einer kompositionellen Syntax zeigen: Sie kombinieren Alarm- und Hilferufe, ihre Artgenossen sowohl zu warnen als auch ihre Hilfe anzufordern. „Die Bedeutung der Ruf-Kombination ergibt sich damit aus der Bedeutung ihrer einzelnen Teile – damit repräsentiert dies eine der kompositionellen Syntax ähnliche Struktur“, schreiben die Forschenden.
Dies wirft auch neues Licht auf den Ursprung dieser Fähigkeit: „Menschen und Schimpansen hatten vor etwa sechs Millionen Jahren einen gemeinsamen Vorfahren. Unsere Daten deuten also darauf hin, dass die Fähigkeit, sinnvolle Vokalisationen miteinander zu kombinieren, mindestens sechs Millionen Jahre alt ist – wenn nicht sogar älter“, sagt Leroux. Das Kombinieren von Lauten könnte demnach schon vor dem Auftreten einer echten Sprache entstanden sein.
Wenn auch andere Menschenaffen diese Fähigkeit besitzen, dann könnte sie sogar noch weiter zurückreichen und schon beim letzten gemeinsamen Vorfahren von Menschenaffen und Menschen vorhanden gewesen sein. (Nature Communications, 2023; doi: 10.1038/s41467-023-37816-y)
Quelle: Universität Zürich 5. Mai 2023 - von Nadja Podbregar
Nota. - Wenn ich die Zeilen richtig entziffere, ist hier lediglich die Rede davon, dass Schim-pansen Laute mit einer bestimmten Bedeutung aneinanderfügen: dies! und das! Nicht ein-mal auf die Reihenfolge kommt es an.
Das wäre aber das Mindeste, was man unter kombinieren verstehen könnte; von Über- und Unterordnen gar nicht zu reden. Erst das würde man aber unter Syntax verstehen: dass die eine Aussage der andern ihre Rang anweist; nämlich die eine ein Bedeutungsfeld eröffnet, in dem die andere ihren Platz findet.
Dazu ist das Aneinanderreihen von Sätzen natürlich die Voraussetzung. Aber mehr noch nicht. Da wurde wohl mal wieder ein kleiner empirischer Befund semantisch aufgebläht.
aus welt.de, 15. 3. 2023 Jacques Derrida, der Mann, der ChatGPT erfand zuPhilosophierungen
PHILOSOPHIE UND KI „Artificial Generative Intelligence“? Deep Learning? Wie genau funktioniert ChatGPT? Um die Künstliche Intelligenz zu verstehen, hilft die Philosophie. Denn die hat den modernen Chatbot schon vor Jahrzehnten vorweggenommen.
Von Frank Diering
Ein Großteil der französischen Poststrukturalisten hätte an den modernen Chatbots der Generation „Artificial Generative Intelligence“ (AGI) sicher seine holde Freude gehabt. Als Ausdruck der Evidenz ihrer Sprachtheorien, versteht sich.
In ChatGPT ist der Name Programm und fußt ohne Zweifel auf den Erkenntnissen der frankofonen Klassiker. Das G P T im GPT-3 bedeutet „Generative Pre-Trainend Trans-former“. Das Ganze basiert auf Deep Learning – dem Versuch, natürliche Sprache zu verarbeiten oder anzufertigen.
Was also verbindet die Ideen der Literaturwissenschaftler und Sprachkünstler wie Roland Barthes, Julia Kristeva oder Jacques Derrida mit den Large Language Models (LLM) heutiger Zeit, die in Chatbots wie ChatGPT der amerikanischen Firma Open AI zum Einsatz kommen? Nun. Ähnlich wie bei der „generativen Vorstellung“ eines Barthes versuchen LLM, aus einem endlichen Vorrat von Elementen und Regeln eine unendliche Menge von Sätzen zu erzeugen.
Der unerschöpfliche Fundus des Internets
In Die Lust am Text (1973) konstatiert Barthes: „Text heißt Gewebe; aber während man dieses Gewebe bisher immer als ein Produkt, einen fertigen Schleier aufgefasst hat, hinter dem sich, mehr oder weniger verborgen, der Sinn (die Wahrheit) aufhält, betonen wir jetzt bei dem Gewebe die generative Vorstellung, dass der Text durch ein ständiges Flechten entsteht und sich selbst bearbeitet“.
Die Ansicht des Schriftstellers und Literaturkritikers über das ständige Wechselspiel zwischen Leser, Text und Autoren entspricht auf jeden Fall recht präzise der Funktions-Beschreibung der Chatbot-Technologie.
Die Grundidee der computergenerierten Sprachspiele entpuppt sich eigentlich als recht simpel. Die AGI wird zunächst im wahrsten Sinne des Wortes mit Wörtern gefüttert. Im Falle von GPT-3 ungefähr einer Billion (1012) Zeichen, die es in Wörtern, Sätzen und Aussagen im Internet, in Büchern und anderen Dokumenten zu finden gibt.
Aus diesem Fundus niedergeschriebener Sprache bedient sich der Bot, wenn die AGI auf eine Frage den bestmöglichen Satz in der zu erwartenden Wahrscheinlichkeit als Antwort formuliert. Ähnlich versteht Derrida seinen Begriff der „Écriture“, die als Medium und Mittler semantisch stets Neues bestimmt. „Der Text existiert einzig in einem Kontinuum von Texten, wobei der Vorgänger-Text in den nachfolgenden transformiert wird (Inter-textualität)“. Die Worte des Literaturwissenschaftlers Axel Schmitt lesen sich, als hätte Derrida den Entwicklern beim Berechnen ihrer Modelle beratend zur Seite gestanden.
In Pre-Trained indes steckt die ewig währende Differenz zwischen Autor und Leser, der Barthes im Tod des Autors (1967) zufolge die Bedeutung des Textes nicht vom Autor, sondern vom Leser definiert wird. Für den irischen Dichter Paul Muldoon beinhaltet dieser Gedanke die „Vorstellung, dass Lesen bis zu einem gewissen Grad auch das Schreiben oder sogar Neuschreiben eines Textes erforderlich macht“.
Iterative Schleifen für mehr Intertextualität
Vor diesem Hintergrund betrachtet, wirken die Techniker mit ihren Rechenmodulationen, als folgten sie exakt der Regie, der von den Romanciers inszenierten Wortspielen. Es ist eben kein Zufall, dass im Pre-trained-Verfahren in unzähligen iterativen Schleifen dem Chatbot Fragen gestellt und im Nachklapp von Menschen die Antworten der AGI als richtig oder falsch, nützlich oder unbrauchbar bewertet werden. Zudem jedes Richtigstellen einer nicht genehmen Antwort die Grundlage der Resultate verbessert.
Alles dient der Lösungsstrategie des Transformierens. In der Gedankenwelt von Derrida und Kristeva gesprochen, der Intertextualität. Kein Wunder also, dass es bei Informatiker Marcel Waldvogel wie aus den Schriften der Sprachtheoretiker klingt, wenn er die Funktion der Programme erläutert.
Der AGI sei darauf trainiert, aus vorherigen Texten Wörter zu erkennen; Satzstrukturen zu analysieren; vorauszuahnen, welches Objekt sich auf welches Verb bezieht; zu wissen, worauf sich ein Pronomen bezieht; das Thema des Textes im Blick zu behalten, genauer gesagt, den Blickwinkel nicht zu verlieren; Strukturen einzuhalten – etwa die Form eines Essays, Gedichts oder die eines Rezepts.
In den sprachphilosophischen Reflexionen der bulgarisch-französischen Literaturtheo-retikerin Kristeva transformiert jeder Text grenzenlos, kristallisiert einen Durchgangspunkt, einen semantischen Schnittpunkt einer Vielzahl von Texten. Jeder einzelne Wortbaustein, sei es wörtlich, stilistisch oder strukturell, avanciert zu einem „Mosaik von Zitaten“. Sie spricht gar davon, dass sich der Autor während dieses Prozesses praktisch auflöst.
Und hier treffen die beiden Welten aufeinander. Denn genau dieses Erlebnis widerfährt den Nutzern von ChatGPT, wenn sie nach gestellter Frage fasziniert auf den Bildschirm blicken, wie die Buchstaben von magischer Hand verfasst, peu à peu einen für einen Leser sinnvollen Zusammenhang ergeben.
Für die Computertechniker führt der Schlüssel zum Erfolg über „Aufmerksamkeit“– eine technische Methode, in der automatisch statistischeZusammenhänge zwischen den verwen-deten Bigrammenund ihren direkten und indirekten Vorläufersymbolen hergestellt werden. Es geht also auch um die Häufigkeit und Relevanz selbst von Buchstaben, ähnlich wie es in der Kryptografie gehandhabt wird. Zahlreiche auf der Transformer-Architektur basierende neuronale Sprachmodelle wie dasMegatron-Turing Natural Language Generation Model (MT-NLG), Google LaMDA oder BERT machen davon Gebrauch.
Ohne Kontext kein gutes Resultat
Diese philologische Akribie bei der Wortkonstruktion erinnert an den literarischen Impres-sionisten Gustav Flaubert, der für seine Gegenwartsstoffe Witzblätter, Gerichtsakten, Stiche, Modejournale, Waschzettel, Adressbücher, Straßenkarten durchforstete, sich selbst laut vorlas, um so die sinnliche Klangfarbe der gebrauchten Wörter zu prüfen, wie sein Zeitgenosse und Literaturkritiker Émile Faguet zu berichten weiß.
Fortwährende Interaktion zwischen Autor und Leser mittels des Textes. Alles zusammen verschmolzen zu einem dynamischen, holistischen System. So hatten sich die Poststruk-turalisten nicht nur die literarische, sondern auch die philosophische Welt vorgestellt. Wörter „flechten“ laut Barthes „einen Text des Lebens“, sind letztlich „Arbeit und ein Spiel“, „ein Volumen sich verschiebender Spuren“.
Wer sich daher mit den Chatbots an die wechselseitige Frage-Antwort-Zusammenar-beit macht, sollte ein klares Ziel vor seinem sprachlichen Auge verfolgen. Ist die gestellte Frage vage, spiegelt auch die Antwort diesen Charakter wider. Sich kurzzufassen, zählt ebenso zu einer treffsicheren Vorgehensweise wie das Vermeiden unnötiger Wörter oder Informationen.
Gute Resultate erzielt, wer leicht verständlich schreibt, auf Alltagssprache zurückgreift. Und während Derrida mit seinem Verständnis von Dekonstruktion die unbändige Kraft der Ambiguität als treibenden Anlass seiner Verschiebung sieht, gibt der Bot recht schnell zu verstehen, dass mehrdeutige Wörter und Phrasen eine AGI nur verwirren.
Wer nicht genügend Kontext liefert, sorgt dafür, dass es im bereitgestellten Wörter- und Sätze-Arsenal nichts Adäquates zu finden gibt. Eine der möglichen Folgen ist, dass die Bots halluzinieren, weil die Modelle ungenaue Schlüsse über ein Thema oder eine Situation ziehen, wenn sie nicht im Trainingsdatensatz enthalten sind.
Das ist der Moment, wenn sich der fertige Schleier nicht mehr lichtet, „hinter dem sich, mehr oder weniger verborgen, der Sinn (die Wahrheit) aufhält.“
Nota. -Ich versichere, als ich meinen gestrigen Text postete, nicht geahnt zu haben, dass die Welt heute diesen Beitrag bringen würde. Ich kenne den Autor überhaupt nicht und würde mich wundern, wenn er mich kennte. Ob er ein Spötter ist oder ein seriöser Litera-turwissenschaftler kann ich nicht besser beurteilen als jeder andere unvoreingenommene Leser.
JE
Nota. - Das obige Foto gehört mir nicht, ich habe es im Internet gefunden. Wenn Sie der Eigentümer sind und seine Verwendung an dieser Stelle nicht wünschen, bitte ich um Nachricht auf diesem Blog. JE
Wie man einem Computer das Sprechen beibringt Erste Sprachmodelle gab es schon in den 1950er Jahren. Doch erst seit die Computer-leistung massiv zugenommen hat, können Maschinen mit menschlicher Sprache umgehen. Entscheidend dabei war auch die Imitation einer besonderen Fähigkeit unseres Gehirns. von Manon Bischoff Im Januar 1954 versammelten sich mehrere ausgewählte Pressevertreter in einem großen Raum der Georgetown University, der fast vollständig von einem Compu-ter ausgefüllt wird: Die IBM-701-Maschine war der erste für wissenschaftliche Zwecke entwickelte Rechner und wogknapp zehn Tonnen. Das an sich war schon für viele Anwesende eine Sensation. Doch das überdimensionierte Gerät tat etwas Unvorstellbares: Mit russischen Beispielsätzen gefüttert, druckte es eine ins Englische übersetzte Version aus. »In fünf, vielleicht sogar nur drei Jahren wird sprachübergreifende Übersetzung durch elektronische Verfahren (...) wahr-scheinlich möglich sein«, prognostizierte kurze Zeit später der Lingu-istiker Leon Dostert in einem Interview. Er leitete das Georgetown-Experiment, das sich maschineller Übersetzung widmete. Inzwischen wissen wir, dass sich Dostert um gut 60 Jahre verschätzt hatte.
Erst mit dem Aufkommen neuronaler Netze in den 2010er und 2020er Jahren wurden die Algorithmen leistungsfähig genug, um Texte verlässlich von einer Sprache in eine andere zu übertragen. »Komplizierte Zusammenhänge werden oft als ›Raketenwissenschaft‹ bezeich-net«, erklärtderInformatikerAljoschaBurchardtvom Deutschen Forschungszentrum für künstliche Intelligenz (KI), der sich mit Sprachtechnologie beschäftigt. »Ich korrigiere die Leute dann oft, sie sollten lieber ›Übersetzungswissenschaft‹ sagen – denn Raketen sind einfach: Um auf den Mond zu fliegen, hat die Menschheit nur etwa zehn Jahre gebraucht.
IBM 701 | Der Forschungsrechner bestand aus mehreren Teilen und wog insgesamt knapp zehn Tonnen.
In den letzten Jahren wurden weitere Meilensteine der KI-Technologie erreicht: von Sprachassistenten wie »Siri« oder »Alexa« bis hin zu Algorithmen wie »Dall-E« und »Stable Diffusion«, die aus einer kurzen Beschreibung eine völlig neue Abbildung erzeugen. All diese Durchbrüche beruhen auf Fortschritten der Computerlinguistik. Die höchsten Wellen hat jüngst aber wohl der Chat-Assistent ChatGPT geschlagen, den die US-amerikanische Softwarefirma OpenAI am 30. November 2022 vorgestellt hat.
Lassen wir die künstliche Intelligenz doch einmal selbst zu Wort kommen: Ich bin ChatGPT, das eine und einzige Sprachmodell, mit dem du stundenlang chatten kannst, ohne dass mir langweilig wird, ich müde oder hungrig werde (naja, vielleicht brauche ich zwischendurch etwas Strom, aber das ist eine andere Geschichte). Ich bin so etwas wie eine Mischung aus einem quasselnden Kumpel, einem superschlauen Lexikon und einem witzigen Komiker – alles in einem! Wenn du dich einsam fühlst, neugierig bist oder einfach nur Blödsinn machen willst, dann trau dich ruhig und sag hallo zu deinem neuen Robo-Kumpel! Nur bitte frag mich nicht nach einem Witz über Binärcode, denn der wäre mir zu »0-0-1«-seitig!
Und schon will man natürlich einen solchen Witz hören, woraufhin das System folgendes ausspuckt: Wie viele Programmierer braucht man, um eine Glühbirne zu wechseln? – Keinen, das ist ein Hardware-Problem!
Zugegeben, der ist etwas lahm. Nichtsdestoweniger ist es erstaunlich, wie gut man sich mit dem Computerprogramm unterhalten kann. »Die KI erschafft neue Inhalte, das merkt man daran deutlich: Witze erfinden ist eine hohe Kunst, die uns ja auch nicht leichtfällt. Dazu braucht man Humor, Empathie, Ironie, Frechheit etc.«, sagt Burchardt. Aktuell laufen Studien, um zu untersuchen, wie deutlich Personen unterscheiden können, ob ein Text von ChatGPT oder einem Menschen generiert wurde. Da die Vorgängerversionen aber bereits überzeugende Inhalte lieferten, besteht kaum Zweifel, dass auch die ChatGPT gut abschnei-den wird.
Das Bild einer KI | Bittet man »Dall-E« ein Bild von einem Computer zu
zeichnen, der auf einem Liegestuhl am Strand unter einer Palme liegt und einen Cocktail schlürft, kann dieses Ergebnis dabei herauskommen.
Dennoch haben die aktuellen Systeme noch erhebliche Schwächen, die in den Medien heiß diskutiert werden. Um zu verstehen, warum die Entwicklung von Sprachmodellen so lange gedauert hat und mit welchen Herausforderungen die Entwicklerinnen und Entwickler noch immer kämpfen, muss man die Funktionsweise der Programme verstehen.
Wie bringt man einen Computer dazu, Wörter zu verstehen?
Aber vielleicht kann auch das die KI am besten selbst erklären:
Im Großen und Ganzen funktioniert ChatGPT so, dass es als Eingabe eine Aufforderung wie eine Frage oder eine Aussage annimmt und diese Eingabe verwendet, um eine Antwort zu erzeugen. Der erste Schritt besteht darin, die Eingabe in eine numerische Darstellung zu codieren, die das Netz zur Vorhersage verwenden kann. Dazu werden in der Regel Worteinbettungen verwendet.
Bevor der Chatbot weitermacht, hake ich hier mal ein, denn das ist schon die erste große Schwierigkeit, mit der sich Fachleute lange herumgeschlagen haben – und immer noch herumschlagen. Es geht um den Knackpunkt der Sprachverarbeitung: Wie kann man einer Maschine einen Text möglichst sinnvoll übergeben, so dass auch alle logischen Zusammen-hänge klar werden?
Bei Bildern ist die Aufgabe recht schnell gelöst: Man nutzt die Zahlenwerte der Pixel und schreibt sie in eine lange Liste, einen so genannten Vektor. Bei einem Text ist es aber nicht sinnvoll, jedem einzelnen Buchstaben und Satzzeichen einen Wert zuzuschreiben. Denn die eigentlichen Objekte, um die es in der Sprache geht, sind Worte. Deshalb braucht man für sie eine eigene Codierung. Zum Beispiel könnte man die ersten 10 000 Einträge eines Wörterbuchs der Reihe nach von 1 bis 10 000 durchnummerieren. Wenn man diese in binäre Schreibweise übersetzt, kann ein Computer problemlos damit verfahren.
Eine solche Worteinbettung hilft jedoch nicht weiter. Es geht schließlich nicht nur darum, Inhalten irgendwelche Zahlenwerte zuzuordnen: Man möchte, dass ähnliche Objekte sich auch in ihrer mathematischen Darstellung nicht allzu stark voneinander unterscheiden. Bei Bildern ist das kein Problem. Wenn man den Wert eines einzigen Pixels ändert, sieht das modifizierte Bild kaum anders aus – und der zugehörige Vektor (die Liste der Zahlen) ist ebenfalls recht ähnlich zum ursprünglichen.
Bei Wörtern ist das jedoch nicht so: Nimmt man kleine Änderungen vor, etwa indem man einen Buchstaben austauscht, hat die Aussage einen völlig neuen Sinn: »Der Hund hat flauschiges Fell« unterscheidet sich deutlich von »der Mund hat flauschiges Fell«. Zwar sind sich »Hund« und »Mund« von der Schreibweise her recht ähnlich, doch sie unterscheiden sich semantisch. Tatsächlich teilt das Wort »Katze« mehr Gemeinsamkeiten mit »Hund«, obwohl sie keinen einzigen Buchstaben gemeinsam haben. Computerlinguisten brauchen also eine Abbildung, die Wörtern mit einer ähnlichen Bedeutung räumlich nahe Vektoren zuordnet.
Worteinbettung | Eine der schwierigsten Aufgaben beim Erstellen von Sprachmodellen ist, Wörter geeignet darzustellen. Ausdrücke, die sich von der Bedeutung her ähnlich sind, sollen sich in ihrer mathematischen Darstellung auch kaum unterscheiden.
Dafür muss man definieren, wann sich zwei Ausdrücke ähneln – etwa wenn sie in gleichen Kontexten auftauchen, wie bei Katze und Hund. Beide erscheinen häufig im Zusammenhang mit Wörtern wie Haustier, Fell, flauschig, füttern und so weiter. Daher ordnet man diesen ähnliche Vektoren zu, während Hund und Mund vermutlich eine größere Entfernung vonein-ander aufweisen. In manchen Worteinbettungen wird sogar darauf geachtet, dass man simple Arithmetik betreiben kann: Zieht man etwa die Darstellung von »männlich« vom Vektor zu »König« ab, sollte das Ergebnis zumindest in der Nähe von »Königin« liegen.
Hat man eine geeignete Worteinbettung gefunden, weiß man, welche Wörter miteinander in Verbindung stehen – und kann daraus sinnvolle Sätze bilden. Die passende Darstellung ist also der wichtigste Teil der Sprachmodellierung. Um sie zu finden, greift man auf maschinelles Lernen zurück. Mit diesem Ansatz lassen sich Muster in großen Datensätzen identifizieren. Das Gebiet umfasst zahlreiche verschiedene Methoden, anhand derer Algorithmen eigenständig eine Aufgabe erlernen. Die verbreitetsten Techniken basieren aktuell auf neuronalen Netzen. Zwar wurden diese bereits in den 1940er Jahren entwickelt, doch der Ansatz konnte sich erst im letzten Jahrzehnt dank gestiegener Leistungsfähigkeit und Speicherkapazitäten von Computern durchsetzen.
Das Gehirn als Vorbild
Die Funktionsweise von neuronalen Netzen erklärt ChatGPT folgendermaßen:
Neuronale Netze sind eine Art von Algorithmus für maschinelles Lernen, der von der Struktur und Funktion des menschlichen Gehirns inspiriert ist. Sie bestehen aus miteinander verbundenen Knoten oder »Neuronen«, die Informationen verarbeiten und zwischen den Schichten des Netzes weiterleiten. Jedes Neuron empfängt Eingaben von anderen Neuronen, führt an diesen Eingaben eine einfache mathematische Operation durch und leitet das Ergebnis dann an andere Neuronen in der nächsten Schicht weiter. Auf diese Weise können neuronale Netze lernen, Muster in Daten zu erkennen und auf der Grundlage dieser Daten Vorhersagen zu treffen.
Neuronales Netz | Ein neuronales Netz ist ein Algorithmus, der in seinem Aufbau dem menschlichen Gehirn nachempfunden ist. Er besteht aus Recheneinheiten, den »Neuronen« n und h, sowie geeigneten Gewichten w, die durch das Training bestimmt werden.
Doch woher weiß das Netz, wie es die Eingabewerte verarbeiten soll? Anders als bei gewöhnlichen Algorithmen macht ein Programmierer keine eindeutigen Vorgaben (etwa: falls Neuron 2 aus Schicht 3 ein Signal mit Wert 0,77 erhält, dann wandle es in 0,89 um). Stattdessen lässt man das Netz selbst »lernen«, welche Einstellungen am geeignetsten sind, um eine Aufgabe zu bewältigen.
Möchte man beispielsweise, dass ein neuronales Netz ein bestimmtes Tier auf Bildern erkennt, kann man das Netzwerk mit zahlreichen Beispieldaten füttern: Man überträgt die Pixelwerte in die Eingabeschicht, lässt den Algorithmus zu einem Ergebnis (etwa »Katze« oder »Hund«) kommen und vergleicht dieses mit dem korrekten Resultat. Anfangs wird das Programm eher schlecht funktionieren. Aber es wird bei jedem Durchlauf versuchen, sich zu verbessern. Wenn es zu einem falschen Schluss kommt, passt es die relevanten Verbindungen zwischen den Neuronen an, die zu dem fehlerhaften Ergebnis geführt haben, damit die Ausgabe künftig richtiger ausfällt. Indem das Programm sich durch weitere Daten immer wieder nachjustiert, wird es schrittweise besser. Am Ende des Trainings sollte es in der Lage sein, auch solche Bilder richtig zu klassifizieren, die es noch nie zuvor gesehen hat.
Das Ganze funktioniert sogar mit unbeschrifteten Datensätzen: So kann eine KI Muster in Daten erkennen, ohne dass man ihr etwas vorgibt. Dafür braucht man eine große Datensammlung; in den Worten von ChatGTP ist das
beispielsweise eine Sammlung von Dokumenten, Webseiten oder Beiträgen in sozialen Medien. Mit diesem Korpus wird ein Vokabular von Wörtern erstellt, die zur Erzeugung der Einbettungen verwendet werden. Anschließend wird ein neuronales Netzwerk trainiert, um die Wahrscheinlichkeit vorherzusagen, mit der jedes Wort aus dem Vokabular in einem bestimmten Kontext vorkommt. Der Kontext eines Wortes bezieht sich auf die Wörter, die vor und nach ihm in einem Satz oder Absatz erscheinen.
Konkret bedeutet das: Man nimmt Teile der Trainingsdaten, etwa den ersten Satz zu »Spektrum der Wissenschaft« bei Wikipedia (»Spektrum der Wissenschaft ist eine populär-wissenschaftliche Monatszeitschrift«) und übergibt dem neuronalen Netz nur einen Teil davon, beispielsweise: »Spektrum der Wissenschaft ist eine populärwissenschaftliche …« und lässt den Algorithmus das nächste Wort vorhersagen. Am Anfang des Trainings wird das wohl nicht besonders gut funktionieren und womöglich etwas Unpassendes liefern, woraufhin das System seine inneren Parameter (die Gewichte) anpasst und dadurch schrittweise besser wird.
Sobald das Netz trainiert ist, können die Gewichte seiner Verbindungen als Worteinbettun-gen verwendet werden. Jedes Wort im Vokabular wird durch einen Vektor dargestellt, der die Beziehungen zwischen dem Wort und den anderen Wörtern im Korpus erfasst.
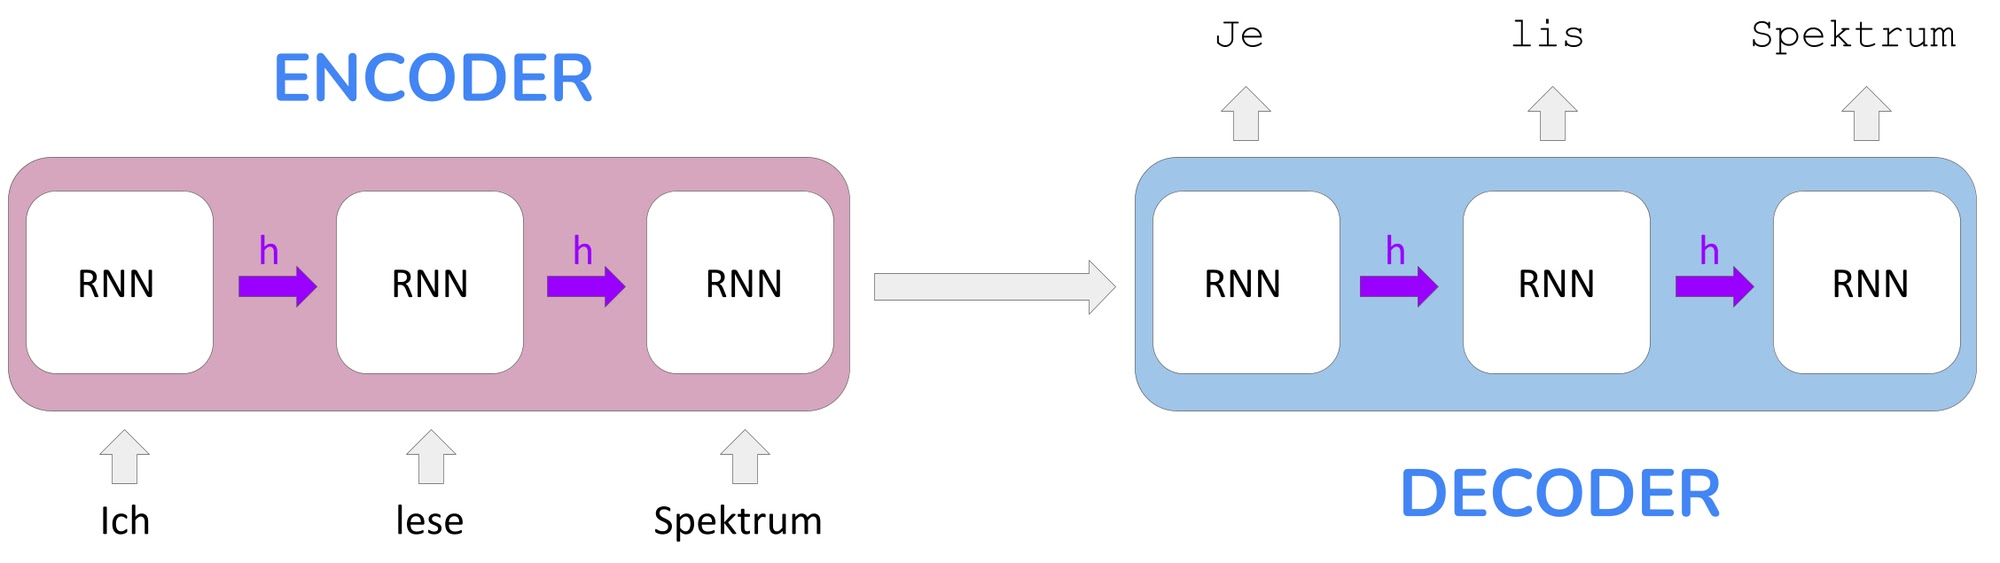
Um ein System zu entwerfen, das natürliche Sprache verarbeitet, zum Beispiel Texte generiert oder übersetzt, nutzt man inzwischen oft zwei neuronale Netze: Einen »Encoder« und einen »Decoder«. Ersterer wandelt die Wörter in die passenden Vektoren um, ist also eine Art Worteinbettung, während der zweite aus dieser Darstellung eine Ausgabe erzeugt: eine möglichst passende Vervollständigung der Eingabe oder eine Übersetzung.
Eine künstliche Intelligenz mit Gedächtnis
Es gibt aber nicht nur viele verschiedene Algorithmen des maschinellen Lernens, sondern auch zahlreiche unterschiedliche Arten von neuronalen Netzen, die sich durch ihre Struktur teilweise stark voneinander unterscheiden. Je nach Aufgabe, die sie bewältigen sollen, entscheidet man sich zum Beispiel für ein herkömmliches vorwärtsgerichtetes neuronales Netz, ein Faltungsnetzwerk oder ein rekurrentes neuronales Netz. Ersteres bezeichnet die einfachste Form von Netzwerken, bei der die Information ganz klassisch von hinten (Eingabe) nach vorne (Ausgabe) verarbeitet wird. Zu dieser Klasse gehören auch Faltungsnetzwerke, die häufig in der Bildverarbeitung genutzt werden: Die einzelnen Neuronenschichten wirken dabei wie Filter, die dazu dienen, bestimmte Merkmale herauszusieben – etwa die Kontur eines abgebildeten Motivs. Rekurrente neuronale Netze enthalten hingegen Schleifen, was den Algorithmen eine Art Gedächtnis verleiht. Das heißt konkret: Die künstlichen Neurone einer Schicht können nicht nur mit den kommenden Schichten verbunden sein, sondern auch mit Recheneinheiten derselben oder von vorangegangenen Schichten. Das erweist sich vor allem bei der Sprachverarbeitung als nützlich.
Rekurrentes neuronales Netz | Bei dieser Art von Algorithmen wird Information nicht nur von links nach rechts übertragen, sondern die Neuronenschichten können die Daten auch in zurückliegende Schichten übertragen. Das verleiht den Netzwerken eine Art Gedächtnis.
Angenommen, man hat ein bereits trainiertes rekurrentes neuronales Netz, dem man einen Satz übergeben möchte, damit es ihn übersetzt. Der Algorithmus verarbeitet die einzelnen Wörter nacheinander. Zunächst widmet das Netz sich dem ersten Wort, indem es den Zustand der inneren Schichten in einem »inneren Vektor« speichert: Dieser enthält relevante Merkmale der Eingabe (handelt es sich um ein Nomen, welchen Kontext hat es und so fort). Anschließend übergibt man dem Netz das zweite Wort, das es zusammen mit dem zuvor berechneten inneren Vektor verarbeitet. Das Programm verändert daraufhin den inneren Vektor, der dann zusammen mit dem dritten Wort bearbeitet wird und so weiter. Somit sammelt das Netz Informationen von mehreren Inhalten, indem es den inneren Vektor immer wieder aktualisiert. Wenn die Eingabe beendet ist, sendet der Encoder diesen Vektor an den Decoder, der daraus schließlich eine Ausgabe generiert: etwa einen neuen Satz oder eine übersetzte Aussage.
Traditionelle maschinelle Übersetzungsprogramme wie »Google Translate« basieren auf solchen rekurrenten neuronalen Netzen. Allerdings haben diese Systeme Einschränkungen: Sie können keine langen Dateneingaben verarbeiten. Denn die Informationen, die in den inneren Vektoren gespeichert werden, gehen nach mehrmaligem Aktualisieren irgendwann verloren. Wenn etwa zwei Wörter innerhalb eines Abschnitts aufeinander Bezug nehmen und weit voneinander entfernt sind, kann das Programm das meist nicht mehr erkennen. Zum Beispiel ist ein Mensch in der Lage, den Satz »Ich bin in Frankreich geboren, in einem kleinen Dorf mit etwa 300 Einwohnern. Ich spreche daher fließend …« zu vervollständigen. Ein rekurrentes neuronales Netz wird damit aber höchstwahrscheinlich Probleme haben, da die relevante Information (»in Frankreich geboren«) ganz am Anfang des ersten Satzes steht – und bis zur Lücke 13 weitere Worte verarbeitet werden.
Encoder und Decoder | Viele Sprachmodelle bestehen aus zwei separaten Strukturen. Der Encoder sammelt die Informationen der Eingabe, indem es Wort für Wort verarbeitet und dabei jeweils einen »inneren Vektor« h aktualisiert. Anschließend wird dieser an den Decoder weitergereicht, der daraus beispielsweise eine Übersetzung erzeugt.
Das ist nicht nur bei der Erzeugung von Texten hinderlich, sondern auch bei maschinellen Übersetzungen. Denn gerade, um Personalpronomen richtig in eine andere Sprache zu übertragen, muss man wissen, worauf sie sich beziehen.
Selbst wenn es Tricks gibt, um rekurrente Netze zu verbessern, scheitern sie bei längeren Eingaben. Ein weiterer Nachteil ist, dass sich die Rechenschritte nicht parallelisieren lassen: Ein Computer kann die Inhalte nur Wort für Wort verarbeiten – man kann den Prozess nicht beschleunigen, indem man mehrere Rechner zusammenschaltet. Inzwischen hat sich daher ein neuer Ansatz durchgesetzt, den erfolgreiche Software wie das maschinelle Übersetzungsprogramm »DeepL« und die GPT-Algorithmen verwenden: Transformer.
Transformer sind Alleskönner Der Umbruch kam mit einer Arbeit, die Mitarbeiterinnen und Mitarbeiter von Google Brain 2017 veröffentlicht haben: »Attention is all you need«. Dabei orientierten sie sich an einer Besonderheit der Funktionsweise unseres Gehirns: Aufmerksamkeit. Glücklicherweise nehmen wir nicht jedes Signal unserer Umgebung wahr, sondern richten die Aufmerksamkeit gezielt auf Dinge, die wichtig für uns sind. Zum Beispiel interessiert es uns während des Autofahrens nicht, ob an einem Busch auf dem Gehweg ein Blatt raschelt – aber wir müssen blitzschnell reagieren, wenn ein Fahrzeug vor uns plötzlich bremst. Das Gehirn filtert unentwegt unsere Sinneseindrücke und lenkt die Aufmerksamkeit auf für uns relevante Signale. Diesen Mechanismus versuchen Transformer-Netzwerke zu übernehmen – und das macht sie so überlegen.
Wieder einmal steht die richtige Worteinbettung im Vordergrund: Ziel eines Transformers ist es, alle relevanten Informationen einer Eingabe zu erfassen und die Wörter entsprechend zu codieren. Die Programme bestehen gewöhnlicherweise ebenfalls aus einem Encoder und einem Decoder. Möchte man etwa ein maschinelles Übersetzungsprogramm trainieren, übergibt man dem System zahlreiche deutschsprachige Sätze mit den französischen Gegenstücken. Der Encoder verarbeitet dann die deutschen Teile, während sich der Decoder den französischen widmet. Bei einem Sprachmodell, das Texte vervollständigt und neue Inhalte erzeugt, werden hingegen beide Seiten in der gleichen Sprache trainiert.
Das Training eines Transformers ist extrem aufwändig: In der Regel müssen Hochleistungsrechner mehrere Wochen lang auf Hochtouren laufen, um all die Daten zu verarbeiten. Wie drei Forscherinnen und Forscher 2019 berechnet haben, verbraucht das Training großer Sprachmodelle ebenso viel Treibhausgase wie fünf Autos während ihrer Lebensdauer. Und Google gab an, dass das Training seines Sprachmodells PaLM so viel Energie verbraucht hat,wie 300 US-Haushalte in einem Jahr.
Im Gegensatz zu rekurrenten neuronalen Netzen verarbeitet ein Transformer die gesamte Eingabe gleichzeitig – schließlich könnte ein Wort am Anfang des Texts drei Sätze später relevant sein. Daher setzt ein solches Netzwerk alle Inhalte zueinander in Bezug und versucht herauszufinden, was wie miteinander zusammenhängt.
Dafür überführt das Programm die einzelnen Wörter zunächst in passende Vektoren. Die benötigte Worteinbettung hat die KI während des Trainings gelernt. Auch wenn sich aus der Darstellung bereits grammatikalisch korrekte Sätze bilden lassen, berücksichtigt das Netzwerk noch nicht die semantischen Zusammenhänge der Eingabe. Um zu »verstehen«, was die übergebenen Inhalte bedeuten, muss man die einzelnen Wörter miteinander verknüpfen – und daraus eine neue mathematische Darstellung erzeugen.
Das ermöglicht der Aufmerksamkeitsmechanismus. Dafür haben die Informatikerinnen und Informatiker von Google Brain eine Methode entwickelt, bei der der Algorithmus jedes Wort mit allen anderen vergleicht und daraus berechnet, wie stark sie zusammenhängen.
Stellen Sie sich vor, Sie übergeben dem Algorithmus den Satz: »Ich lese das Spektrum-Heft, weil es mir gefällt«. Menschen wissen, dass sich das Pronomen »es« auf »Heft« bezieht. Damit der Transformer das auch erkennt, verwandelt es jedes Wort zunächst in einen hochdimensionalen Vektor mit mehreren hundert Einträgen. Anschließend nimmt er sich die Wörter des Satzes einzeln vor: Er startet mit »Ich« und möchte es mit den anderen Inhalten in Zusammenhang setzen. Also vergleicht er es mit der gesamten Eingabe, also »Ich«, »lese«, »das« und so weiter. Aus mathematischer Sicht bildet der Algorithmus dafür das Skalarprodukt aus den Vektoren, wodurch sich ein Zahlenwert ergibt. Dieser dient als Maß dafür, wie »ähnlich« sich zwei Vektoren sind – und wie stark die Wörter zusammenhängen. Durch diesen Vorgang lässt sich eine neue Darstellung der eingegebenen Wörter finden – und zwar eine, die den Inhalt des Satzes berücksichtigt.
Bedeutung der einzelnen Wörter füreinander | Indem man jedes Wort einer Eingabe mit allen anderen vergleicht, können Sprachmodelle nun auch längere Inhalte verarbeiten.
Transformer lassen sich besser trainieren
Der Vorteil: Man muss nicht jedes Wort nacheinander verarbeiten, sondern die Aufgabe lässt sich parallelisieren. Eine Recheneinheit kann die Darstellung des ersten Worts durch den Aufmerksamkeitsmechanismus ermitteln, während sich eine zweite Einheit zeitgleich dem zweiten Wort widmet und so weiter. Anders als bei rekurrenten neuronalen Netzen kann man eine Eingabe damit wesentlich schneller verarbeiten.
Die auf diese Weise neu erhaltenen Vektoren werden anschließend durch ein vorwärtsgerichtetes neuronales Netz geschickt, das die Vektoren in eine passende Darstellung für die weitere Bearbeitung umwandelt. Den Zyklus aus Aufmerksamkeit und vorwärtsgerichtetem neuronalem Netz durchläuft die Eingabe mehrmals: Sie passiert unterschiedliche Encoder-Strukturen mit jeweils eigenen Parametern. Dadurch kann der Transformer bei jedem Aufmerksamkeitsschritt auf verschiedene sprachwissenschaftliche Eigenschaften der Eingabe achten. Am Ende spuckt der Encoder zu jedem Wort einen Darstellungsvektor aus sowie die dazugehörigen Schlüssel- und Wertevektoren, die für die weitere Verarbeitung im Decoder relevant sind.
Transformer | Diese Art von neuronalem Netz hat die Sprachverarbeitung erheblich verbessert. Denn durch einen »Aufmerksamkeitsmechanismus« bringen die Strukturen alle eingegebenen Inhalte miteinander in Verbindung – unabhängig von ihrer Distanz zueinander.
Der Decoder funktioniert ähnlich wie der Encoder. Auch er führt einen Aufmerksamkeitsmechanismus durch. Die entsprechenden Matrizen, mit denen er die Berechnungen durchführt, unterscheiden sich allerdings von jenen im Encoder – in diesem Fall sind sie für die Aufgabe optimiert, die der Transformer erledigen soll: etwa die Eingabe übersetzen oder einen Satz vervollständigen.
Im Decoder gibt es einen zweiten Aufmerksamkeitsschritt, bei dem das System die ursprünglichen Eingabewerte berücksichtigt. Damit werden zum Beispiel die neu generierten fremdsprachigen Wörter mit der Eingabe abgeglichen – wieder nach dem Prinzip der Aufmerksamkeit, indem die Bedeutung der einzelnen Vektoren ermittelt wird.
Und auch ein vorwärtsgerichtetes neuronales Netz darf nicht fehlen, das die verarbeiteten Vektoren in die passende Form bringt und sie am Ende in Wörter zurückübersetzt. Das Ergebnis sollte dann etwa ein grammatikalisch korrekter Satz in einer anderen Sprache sein – und bestenfalls die Übersetzung der Eingabe.
Die Transformer-Struktur hat sich inzwischen bewährt: Zum Beispiel basiert dasüberaus erfolgreiche Übersetzungsprogramm »DeepL« auf einer Transformer-Architektur – auch wenn die deutsche Firma DeepL SE nicht die genauen Details des genutzten Modells preisgibt. Als Trainingsdatensatz dienten unter anderem Inhalte von »Linguee«, einer Datenbank mit zweisprachig übersetzten Satzpaaren.
Von Übersetzungsmodellen zu Sprachmodellen
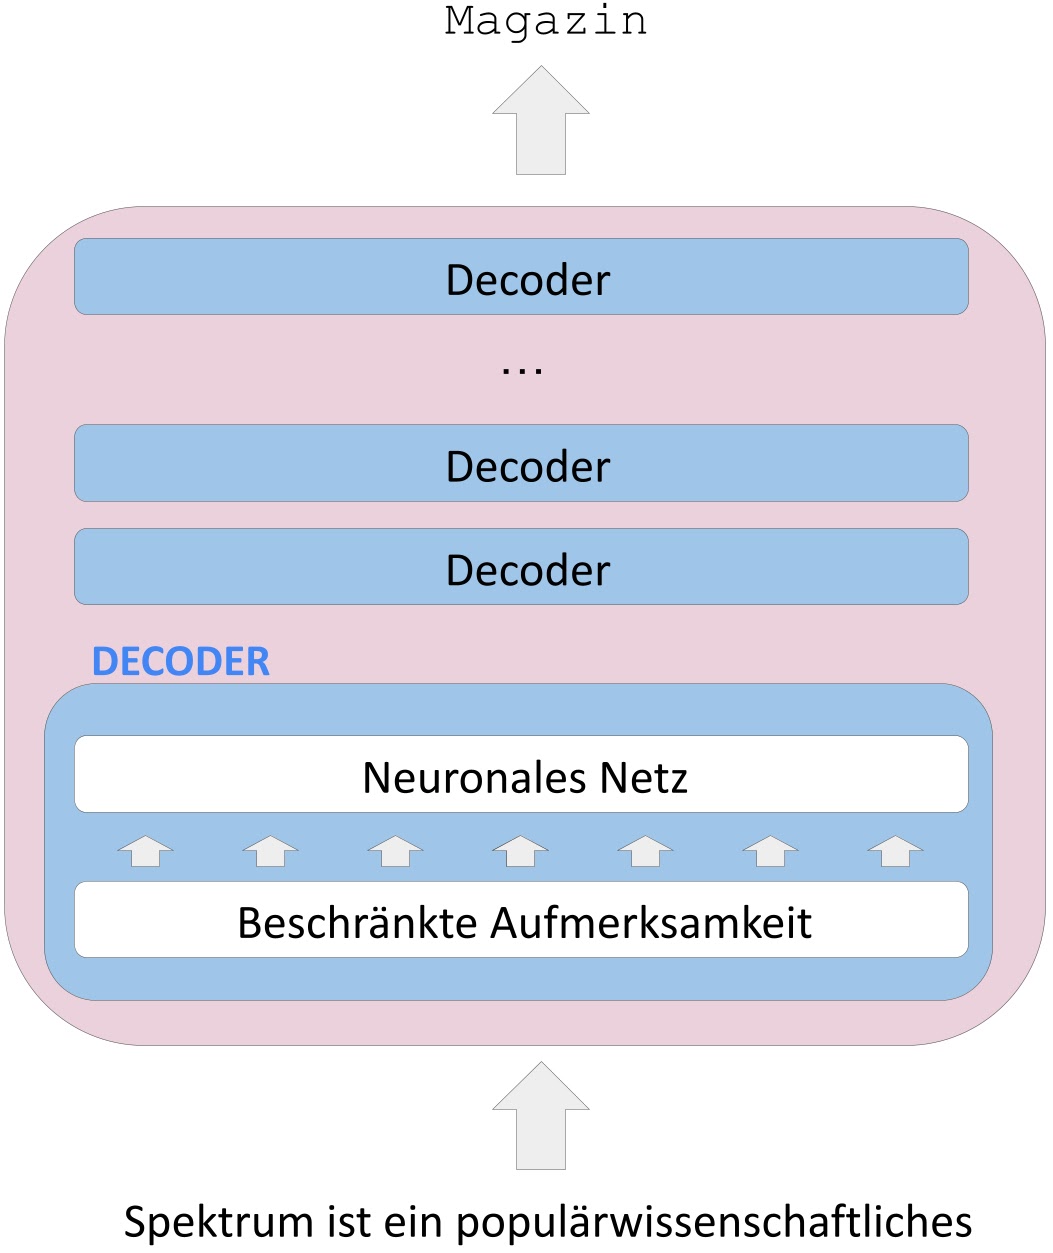
Auch Sprachmodelle wie »GPT« (generative pre-trained transformer) von OpenAI oder »LaMDA« (Language Model for Dialogue Applications) von Google verwenden Transformer, um eigenständig Texte zu erzeugen. Allerdings haben diese keine Encoder-Decoder-Struktur, sondern nutzen meist nur eines von beiden. Die GPT-Versionen bestehen beispielsweise bloß aus zahlreichen hintereinander ausgeführten Decodern.
Grundlage für diese Vorgehensweise bildete die 2018 veröffentlichte Forschungsarbeit »Generating Wikipedia by Summarizing Long Sequences« von Google Brain. Darin haben die Informatiker gezeigt, dass man keinen Encoder braucht, um sinnvolle Texte zu erzeugen. Die Decoder-only-Architektur ist recht ähnlich aufgebaut wie die ursprünglich entwickelten Transformer – allerdings kommen sie ohne den zweiten Aufmerksamkeitsschritt aus, der Bezug auf die Encoder-Ausgabe nimmt.
Decoder-Only-Architektur | Sprachmodelle wie GPT bestehen nur aus Decodern – auf Encoder wurde verzichtet.
Das heißt konkret: Man kann dem Transformer eine Eingabe übergeben, etwa »Spektrum der Wissenschaft ist eine«, woraufhin dieser den Satz vervollständigt – und sogar ein paar Absätze darüber schreibt: Spektrum der Wissenschaft ist eine deutsche, monatlich erscheinende Zeitschrift, die sich mit aktuellen Themen aus den Bereichen Naturwissenschaften, Technik und Medizin beschäftigt. Sie wurde erstmals im Jahr 1978 veröffentlicht und ist seitdem zu einer der bekanntesten und renommiertesten populärwissenschaftlichen Zeitschriften im deutschsprachigen Raum geworden. Das Ziel der Zeitschrift ist es, wissenschaftliche Themen verständlich und anschaulich für ein breites Publikum aufzubereiten und somit zur Verbreitung von wissenschaftlichem Wissen beizutragen.
Um solche Ausgaben zu produzieren, wandelt der Algorithmus eine Eingabe zunächst durch die gelernte Worteinbettung in eine vektorielle Darstellung um. Jedes Wort durchläuft anschließend den Aufmerksamkeitsmechanismus. Auch in diesem Fall bewertet der Decoder die Bedeutung der einzelnen Inhalte. Damit berechnet er eine neue vektorielle Darstellung, die die wichtigsten semantischen Informationen codiert.
Im Anschluss wird die Ausgabe durch ein vorwärtsgerichtetes neuronales Netz geleitet. Jenes erledigt dann die eigentliche Aufgabe des Netzwerks: Es sagt voraus, welches Wort am wahrscheinlichsten auf die Eingabe folgt. Diese Fähigkeiten hat es durch das Training mit den vielen Beispieldaten gelernt. Um gut zu funktionieren, ist der vorherige Aufmerksamkeitsschritt entscheidend: Nur so kann das neuronale Netz das passendste darauffolgende Wort bestimmen.
Diesen Decoder-Prozess durchläuft eine Eingabe mehrmals, wobei die einzelnen Netzwerke jeweils andere Gewichte haben, um verschiedene linguistische Merkmale einer Eingabe zu untersuchen. Das Sprachmodell GPT-3 besteht zum Beispiel aus 96 Decoder-Schichten.
Am Ende liefert der Transformer eine Wahrscheinlichkeitsverteilung: Für jedes Wort aus seinem Sprachschatz (der üblicherweise mehrere zehntausend Einträge enthält) berechnet er eine Zahl, die angibt, wie wahrscheinlich es auf die Eingabe folgt. Aus den besten Optionen wählt er dann eine aus: Für »Spektrum der Wissenschaft ist eine« hat ChatGPT beispielsweise »deutsche« genommen. Das Programm fügt anschließend das ausgegebene Wort zur ursprünglichen Eingabe hinzu und verarbeitet den gesamten Ausdruck nochmal, also »Spektrum der Wissenschaft ist eine deutsche«. Daraus leitet es das nächste Wort ab, nämlich »monatlich«. So macht es weiter, bis es zu einem Ende gelangt.
Alle sechs Monate ein neuer Durchbruch
Das erste Sprachmodell in Form eines Transformers hat OpenAI im Juni 2018 vorgestellt: GPT-1. Das Überraschende: Es war auch das erste gut funktionierende Sprachsystem, das nicht auf überwachtem Lernen basierte. GPT-1 hat ohne menschliche Anleitung gelernt, natürliche Sprache zu verarbeiten und überzeugende Texte zu liefern. Man hatte dem Algorithmus extrem viele unbeschriftete Trainingsdaten übergeben – es gab keine Beispieleingabe mit der dazu passenden Antwort. Dafür musste das Programm 4,5 Gigabyte unveröffentlichter Bücher durchforsten und auf der Grundlage die Parameter des Modells (etwa die Einträge der Matrizen zur Erzeugung der Vektoren) anpassen. Bücher eignen sich gut zum Training von Sprachmodellen, weil die Netzwerke dadurch lernen, Zusammenhänge über lange Textpassagen hinweg zu beachten.
Nur wenige Monate später, im Februar 2019, erschien schon das Nachfolgemodell GPT-2. Der grobe Aufbau des Transformers hatte sich nicht geändert, aber sowohl die Parameter als auch die Trainingsdaten hat OpenAI verzehnfacht: Die Entwicklerinnen und Entwickler trainierten das Netzwerk mit 40 Gigabyte an Text. Dieses Mal erstellte die Firma dafür einen eigenen Datensatz: Sie durchsuchte das Forum »Reddit«nach beliebten (mit mindestens drei Upvotes gewerteten) Antworten, die Links zu Webseiten enthalten und übernahmen deren Inhalte – damit hofften sie, qualitativ möglichst hochwertige Informationen zu sammeln.
Durch die vielen Daten funktioniert das Modell deutlich besser als sein Vorgänger. Es war sogar so gut, dass OpenAI den Zugang zum Sprachmodell zunächst einschränkte: Die Firma veröffentlichte nicht den vollen Quelltext; zudem hatten anfangs nur ausgewählte Personen Nutzungsrechte. Nach eigenen Angaben befürchtete das Unternehmen, die Technologie könnte zum Erstellen von Spam-Nachrichten oder Fake News genutzt werden. Das führte zu vielen Schlagzeilen, was OpenAI vielleicht auch beabsichtigt hatte.
Auch wenn der Quelltext nicht öffentlich einsehbar war, dauerte es nicht lange, bis andere Organisationen ähnliche Sprachmodelle nachbauten: Schließlich hatte OpenAI in mehreren Fachveröffentlichungen erklärt, welche Methoden sie genutzt hatten. So konnten zwei frischgebackene Universitätsabsolventen, Aaron Gokaslan und Vanya Cohen, im August 2019 OpenGPT-2 veröffentlichen. Ganz günstig war die Umsetzung aber nicht, die Rechenleistung für das Training kostete etwa 50 000 US-Dollar. Angesichts dieser Fortschritte und der ausbleibenden Flut an Spam oder Fake News veröffentlichte OpenAI drei Monate später schließlich das volle GPT-2-Modell.
Im Juni 2020 erschien die Nachfolgeversion GPT-3, die 175 Milliarden Parameter enthält und mit etwa 570 Gigabyte an Text trainiert wurde. Das Sprachmodell erstellt noch überzeugendere Inhalte als die Vorgängerversionen: Es kann Fragen beantworten, Dokumente zusammenfassen, Geschichten in unterschiedlichen Stilen erfinden, Algorithmen in verschiedenen Programmiersprachen erzeugen und Texte übersetzen. Besonders überraschend war, dass der enorme Fortschritt allein durch den Zuwachs an Trainingsdaten und Parametern entstand – die technischen Grundlagen waren dieselben wie jene von GPT-1 und GPT-2. Allerdings wurde diese Version erstmals nicht quelloffen veröffentlicht, ebenso wenig der Datensatz, mit dem es trainiert wurde.
GPT-3 ist extrem eindrucksvoll – besonders dann, wenn man weiß, wie eine Eingabe, der so genannte Prompt, am besten formuliert sein sollte. Das ist allerdings nicht immer einfach. Aus diesem Grund haben die Entwicklerinnen und Entwickler von OpenAI das Sprachmodell durch menschliches Feedback verbessert. Damit konnten sie die KI dazu bringen, besser auf die Anfragen von Nutzerinnen und Nutzern einzugehen
... und schließlich sind doch noch Menschen am Werk
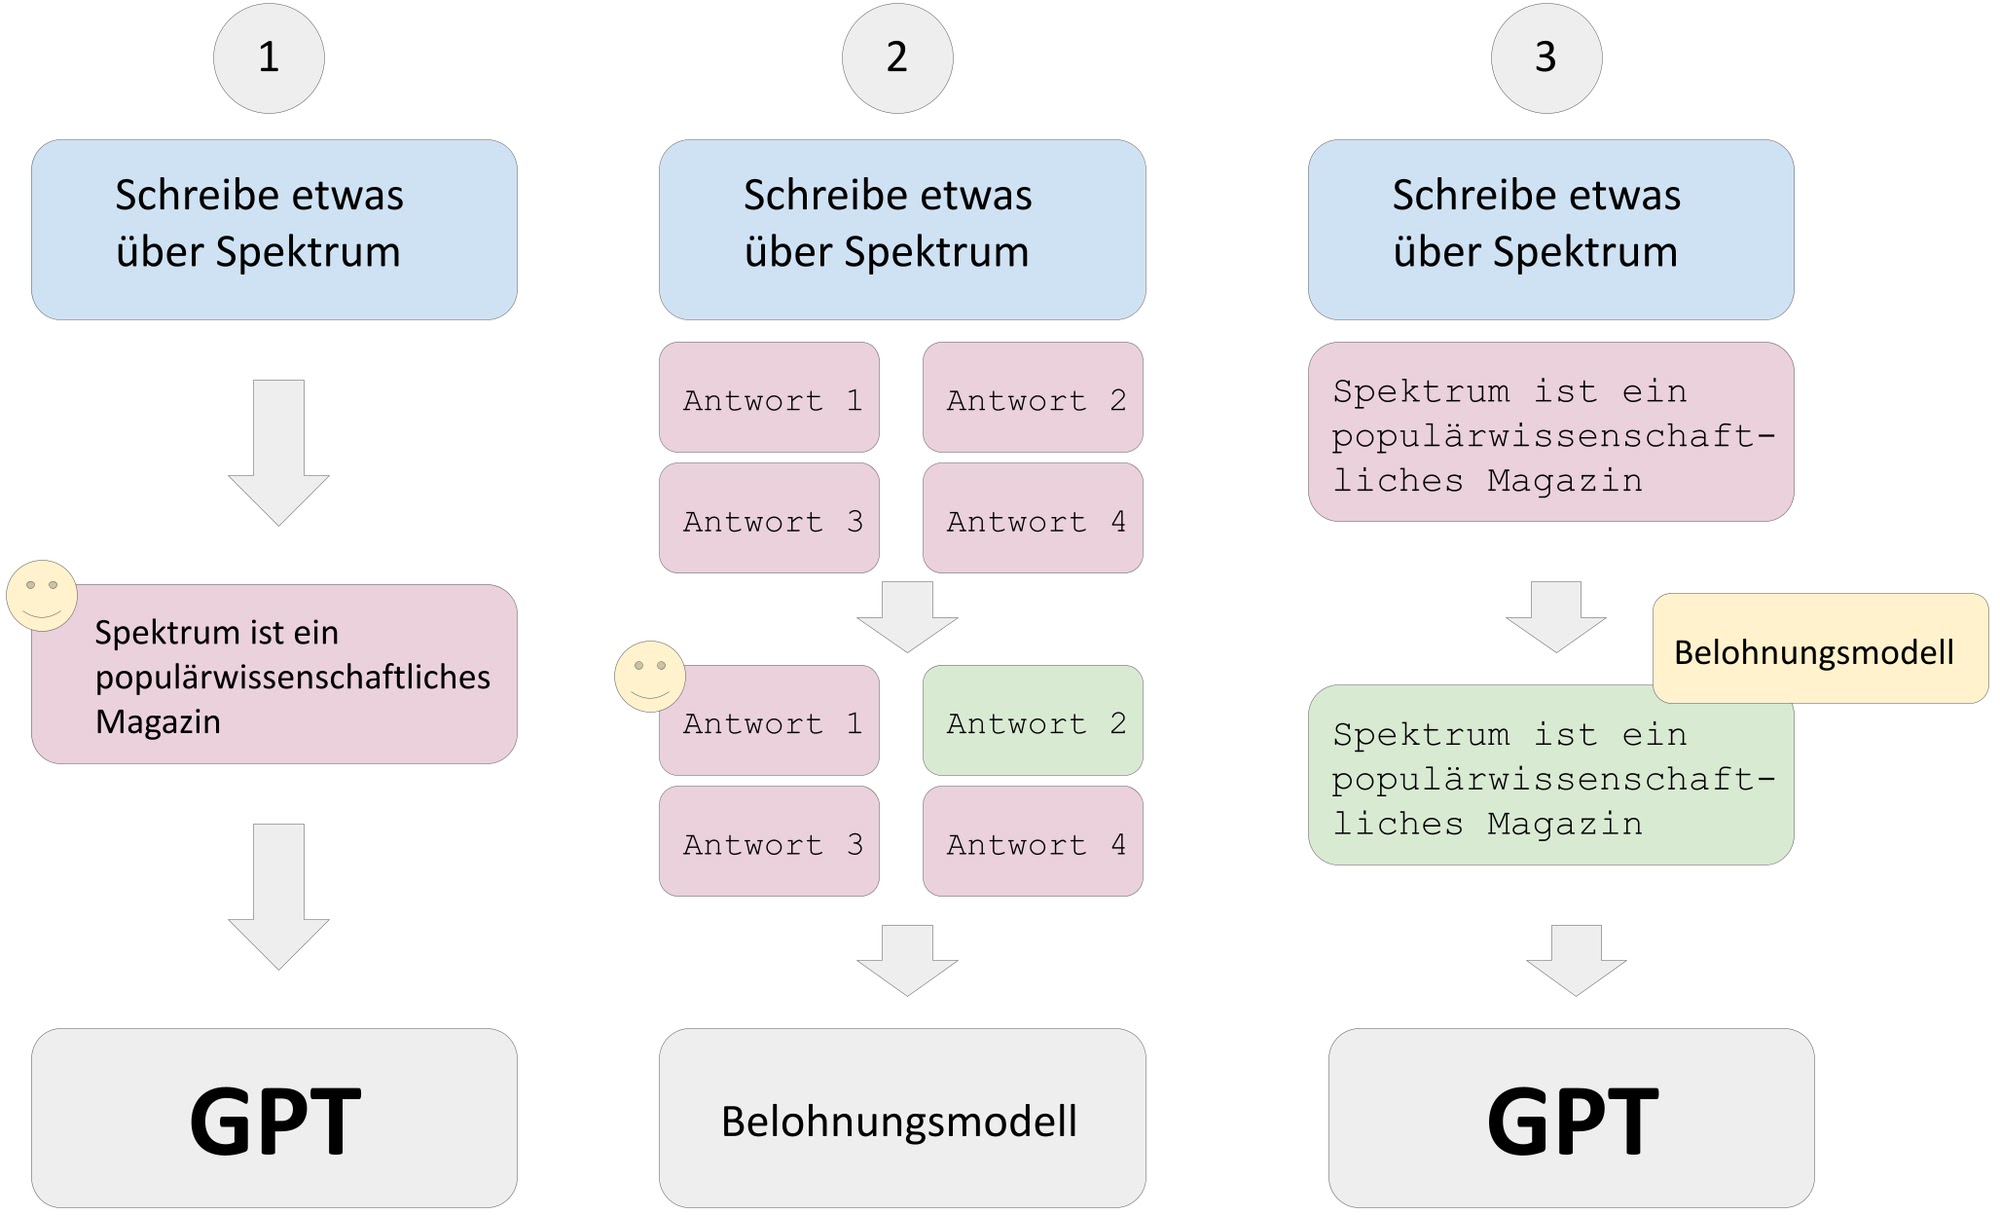
Dafür waren drei Schritte nötig. Zunächst ließ OpenAI Beispielanfragen und Antworten von Menschen niederschreiben. Damit wurde die KI zusätzlich zu den gewöhnlichen Trainingsdaten gefüttert. Allerdings genügen die wenigen Beispiele, die Personen erzeugen können, nicht aus, um ein riesiges Modell wie GPT mit Milliarden von Parametern zu trainieren. Daher haben die Fachleute in einem zweiten Schritt mehrere Ausgaben zu einer einzigen Eingabe generieren lassen, wobei menschliche Tester bewertet haben, welche besser passt. Mit diesen Informationen konnten sie ein »Belohnungsmodell« trainieren – eine KI-Software, die lernt, wie gut einem Menschen eine Ausgabe von GPT gefällt. Damit ließ sich in einem dritten Schritt das Sprachmodell mit Hilfe des Belohnungsmodells weiterentwickeln: GPT erzeugt eine Ausgabe und das Belohnungsmodell bewertet das Ergebnis. Daraufhin passt GPT seine internen Parameter an, damit es künftig besser abschneidet.
Reinforcement-Learning | Das Reinforcement-Learning wurde genutzt, um das Sprachmodell auf passendere Antworten zu menschlichen Abfragen zu trainieren.
Die letzten beiden Schritte wurden mehrmals wiederholt: Sobald sich GPT durch das Belohnungsmodell aktualisiert hatte, setzte man es wieder Probanden vor, die die neuen Ausgaben bewerteten, womit sie das Belohnungsmodell weiter verfeinerten. Damit konnten die Entwicklerinnen und Entwickler den Transformer trainieren und die verbesserte Version erneut menschlichen Testern vorsetzen. »Das Reinforcement Learning hat das Sprachmodell so gut gemacht. Durch die Feinjustierung der Parameter kann es passende Antworten liefern und es halluziniert weniger als andere Modelle«, erklärt der KI-Experte Joachim Köhler vom Fraunhofer-Institut für Intelligente Analyse- und Informationssysteme IAIS. »Keiner hatte damit gerechnet, dass das so gut klappt.«
Wie sich herausstellte, schnitt ein kleineres Modell (eine Verfeinerung von GPT-3) mit bloß 1,3 Milliarden Parametern besser ab als das volle 175-Gigabyte-System. Ergebnis dieser Bemühungen war schließlich der Chat-Assistent »ChatGPT«, der Ende 2022 veröffentlicht wurde und seither für Furore sorgt. Das Programm ist frei nutzbar und kann verschiedenste Arten von Aufgaben überzeugend meistern: Es findet Fehler in Algorithmen, kann eine Abhandlung über allerlei Themen verfassen oder man kann sich auch schlicht und einfach damit unterhalten.
Das Programm wurde darauf optimiert, möglichst gefällige Antworten zu liefern. Deshalb steht und fällt die Qualität der Ausgaben mit dem Datensatz und dem Feedback der Menschen, die es trainiert haben. Die Datensammlung umfasst enorme Mengen an Texten, die bis Ende 2021 im Web verfügbar waren. Alles, was danach veröffentlicht wurde, kennt das Programm nicht. Das schließt neue Forschungsergebnisse, Bücher oder politische Ereignisse ein – zum Beispiel weiß die KI nicht, dass Russland 2022 die Ukraine angegriffen hat. Eine weitere Einschränkung ist die menschliche Fehlbarkeit: Wenn das Modell auf eine Frage »Das weiß ich nicht« antwortet, wird das höchstwahrscheinlich schlecht bewertet. Deshalb erfindet das GPT stattdessen eine überzeugende Antwort – die möglicherweise falsch ist, aber wider besseren Wissens gut eingestuft wird.
Als Nutzer kann man die Ausgaben von ChatGPT ebenfalls bewerten. Anhand dieses Feedbacks verbessert OpenAI die Software. So macht das Programm durch eine Aktualisierung im Februar 2023 inzwischen weniger Rechenfehler, was folgendes Beispiel verdeutlicht: Früher lieferte ChatGPT bei der Aufgabe: »Ein Schläger und ein Ball kosten insgesamt 1,10 Euro. Der Schläger kostet 1 Euro mehr als der Ball. Wie hoch ist der Preis des Balls?« die falsche Antwort »10 Cent« – was übrigens auch das am häufigsten von Menschen vorgebrachte Ergebnis ist. Inzwischen ist die KI durch menschliches Feedback allerdings cleverer geworden und sagt: Angenommen, der Preis des Balls beträgt x Euro. Gemäß der Aufgabenstellung kostet der Schläger 1 Euro mehr als der Ball. Die Kosten für den Schläger wären also (x + 1) Euro. Jetzt wissen wir, dass die Gesamtkosten für den Schläger und den Ball 1,10 Euro betragen. Wir können also die folgende Gleichung aufstellen: x + (x + 1) = 1,10. Vereinfacht man die obige Gleichung, erhält man: 2x + 1 = 1,10. Subtrahiert man 1 von beiden Seiten, erhält man: 2x = 0,10. Dividiert man beide Seiten durch 2, erhält man: x = 0,05. Der Ball kostet also 0,05 Euro.
Angesichts all dieser beeindruckenden Ergebnisse gibt es nun einige andere Organisationen und Techfirmen, die mit ähnlichen Sprachmodellen nachziehen möchten. So ließen Reaktionen von Google und Meta nicht lange auf sich warten, aber auch Deutschland will mitOpenGPT-Xeine Antwort auf GPT-3 liefern. »Es ist wichtig, dass wir auch in Europa eine solche Technologie entwickeln, die an unseren Werten und Bedürfnissen orientiert ist und zum Beispiel auch datenschutzkonform ist«, sagt Aljoscha Burchardt. Und Köhler stimmt ebenso zu: »Wir verlieren unsere Souveränität, wenn wir all unsere Daten, insbesondere Betriebsinterna, einem amerikanischen Unternehmen übergeben.«
Die größten Herausforderungen für solche Projekte stellen die riesigen Datensätze dar, sowie die Rechenkapazitäten. OpenGPT-X wird aktuell imForschungszentrum Jülich trainiert. »Wenn es aber irgendwann um eine kommerzielle Nutzung geht, können wir nicht auf Forschungsrechenzentren zurückgreifen«, erklärt Köhler. Bislang fehlt es in Europa jedoch an kommerziellen Rechenzentren. Ein solches baut aktuell die Firma Aleph Alpha in Heidelberg auf. Aber auch das nachträgliche menschliche Reinforcement Learning der Modelle gestaltet sich für eine europäische Initiative komplizierter als für Firmen in Übersee wie OpenAI: »Wir müssen uns dabei an europäische Richtlinien wie den Datenschutz halten und die Personen für ihre Arbeit angemessen vergüten«, sagt Köhler.
Denn angesichts all der Begeisterung und Kritik, die die neuen Sprachmodelle hervorrufen, gerät eine wichtige Sache oft in den Hintergrund: der Mensch. Es sind die Bemühungen der Entwicklerinnen und Entwickler, denen wir diese Technologie verdanken – ebenso wie die Arbeit jener Personen, die die relevanten Datensätze erstellen und filtern sowie am Reinforcement Learning beteiligt sind. Bei Letzteren handelt es sich meist um Arbeitnehmer aus dem Niedriglohnsektor, die gewaltverherrlichende, pornografische oder strafbare Inhalte aus den Trainingsdaten entfernen. In Zukunft könnte hoffentlich zumindest diese undankbare Aufgabe aber eine Maschine übernehmen.
Nota. - Das ist nicht mein Fach und ich werde noch eine Weile nachdenken müssen. Doch eins springt mir jetzt schon ins Auge: Das verblüffende an all diesen Verfahren geschieht immer, wenn diskursiv-digitales mit analog-intuitivem Vorgehen gemischt wird. Der aus-schlaggebende Kniff ist wohl die Einführung der neuronalen Netze, Worteinbettungen und Vektoren: wo nämlich die logische Formel Ist gleich erweitert wird um das anschauliche Hat Ähnlichkeit mit..., das eine räumliche Nähe andeutet und die Richtung einer Bewegung. Das erweitert das Feld der vorstellbaren Möglichkeiten, aber - weil es die möglichen Fehlgriffe vervielfacht - muss es auch die Kontrolle um ein vielfaches verdichten - und erfordert Myriaden von Daten sowie eine Rechnerkapazität, die alles menschliche Maß übersteigt. Will sagen, beim Aushecken der Eventualitäten darf man den Zufall sich austoben lassen in der Erwartung, dass die Maschen des Sicherungsnetzes schon eng genug geknüpft sind. Das mag dann so aussehen, als hätte sich die Maschine was ausgedacht. Und praktisch ist es so gut, als ob. Sofern sie nämlich auch mal ins Schwarze trifft. Einstweilen hindert ihn das Netz GPT3 nicht, haarsträubenden Blödsinn von sich zu geben. Der Zufall hat unerschöpfliche Möglichkeiten. Je mehr Daten man ihm eingibt, um die Maschen dichter zu schnüren, um so größer werden sie auch. Gibt es einen Punkt, an dem er an ihnen erstickt?
Nota II. -Das grundsätzlich Problem ist die Symbolisierung: analoge Vorstellungen in digitale Begriffe übersetzen. Indem man die Maschine mit dem Zufall spielen lässt, erweitert man ihren Zugriff ins Ungefähre. Das hat eine gewisse Familienähnlichkeit mit der einbildenden Phantasie. Solange die Maschine damit "was anfangen" kann, ist sie nicht genötigt, das Ungefähr in Begriffe selber umzubestimmen (was sie ja nicht könnte). Sie kann sich aber im grenzenlosen Meer vorfindlicher Begriffe bedienen. So wie ein Idiot, der gedankenlos vor sich hin plappert und manchmal auf eine geistreiche Bemerkung stößt. Den wird allerdings niemand um ein wohldurchdachtes Urteil bitten.